

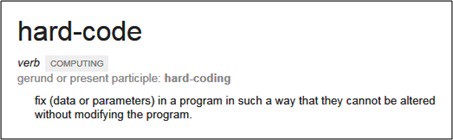
صبر کنید، فقط صبر کنید! هر چیزی که شما بهصورت Hard Code استفاده میکنید، به سادگی قابل تغییر نیست و احتمال شکست شما و پروژههایتان را بالا میبرد.
📩 با عضویت در خبرنامه، جدیدترین مطالب و آموزشها را مستقیم در ایمیل خود دریافت کنید.
مثال: شما یک پروژه گرفتهاید که کارفرما میخواهد یکسری اطلاعات را از یک سایت استخراج کنید و برای این کار اول باید لاگین شوید. سادهترین راه، استفاده از یک مرورگر و ذخیرهی کوکیهای سایت در برنامهی خودتان برای استفادهی دوباره از آنهاست؛ اما اصلاً به طول عمر کوکیها توجه کردهاید؟
# This is bad. Don't do this
headers = {"Cookie": "_session=23ln4teknl4iowgel"}
for url in url_list:
    response = requests.get(url, headers=headers)
Code language: PHP (php)
خب این مشکل را چطور برطرف کنیم؟ سادهترین راه، پیادهسازی عملِ لاگین در وبسایت است.
s = requests.Session()
s.post("https://fakewebsite.com/login", login_data)
for url in url_list:
    response = s.get(url)
Code language: JavaScript (javascript)
در ظاهر این کار وقت نسبتاً زیادی از شما میگیرد، اما کار شما را بعداً سادهتر خواهد کرد.
به سایت حمله نکنید
منظورم حملات منع سرویس به یک سایت است که همهی ما آن را با حملهی DDOS میشناسیم. اگر فکر میکنید که جزو افرادی نیستید که این کار را انجام میدهند، آماده باشید که میخواهم ذهنتان را منفجر کنم. به کد زیر دقت کنید:
for page in range(1000):
    response = requests.get("https://search.com?page=" + page)
Code language: JavaScript (javascript)
نوشتن یک حلقه برای دسترسی مکرر به یک سایت، یکجور حمله حساب میشود. این از همان کارهایی است که باعث میشود IP شما از سمت سایت Ban شود و در نتیجه مجبور شوید از لیستهای پروکسی استفاده کنید.
خب چه راهحلی برای این مشکل وجود دارد؟ خیلی ساده است، فقط کافی است کمی وقفه در کار ایجاد کنید. برای مثال نمونهای از Stack Overflow پیدا کردم که با زبان Python نوشته شده:
from random import randint
from time import sleep

for page in range(1000):
    response = requests.get("https://search.com?page=" + page)
    sleep(randint(2, 5))
Code language: JavaScript (javascript)
این کار به شما کمک میکند که از Ban شدن جلوگیری کنید.
دست از نوشتن Scraperهای تکرشتهای (Thread) بردارید
خیلی سریع میشود، نه؟ درست میگویید، من در قسمتهای بالا گفتم DDOS نکنید، پس چرا الان میگویم از Thread استفاده کنید؟ این بخش برای خزندههایی است که باید بهصورت همزمان روی چند سایت مختلف کار کنند.
از الگوهای تکراری استفاده نکنید
بسیاری از سایتها تشخیص میدهند که شما در حال استفاده از یک الگوی تکراری هستید و این کار احتمال Ban شدن شما را بالا میبرد.
مثال: فکر کنید قرار است از سایت دیوار، آگهیهای تمام شهرها را استخراج کنید؛ با فرض اینکه شهرها با کدهایی از ۰ تا ۱۰۰ شناسایی میشوند، سادهترین کاری که میکنید این است که یک حلقه میسازید و آنها را پیمایش میکنید. اما بهتر است یکبار از اول و بار دیگر از آخر شروع کنید و الگوهای غیرقابلپیشبینی بسازید.
یکی از راههای ساخت الگوهای ناهماهنگ، استفاده از User Agent هاست که دو منبع خوب برای آنها اینجا میگذارم:
نتیجهگیری
Web Scraping کار خیلی سختی نیست؛ بهترین کاری که میتوانید برای خودتان انجام دهید، ساختن ابزاری است که بتوانید بارها و بارها از آن استفاده کنید.
اگر برای پروژهی Web Scraping خودتان به کمک نیاز دارید، حتماً با من تماس بگیرید. در ضمن نظرتان را هم برایم بنویسید.